Alibaba har frigivet modelvægtene til Qwen3.8-Flash-Next, så udviklere kan afprøve og evaluere modellen. Vægtene udgør en forhåndsvisning af den kommende Qwen4-arkitektur. Qwen3.8-Flash-Next er en multimodal mixture-of-experts-model (MoE) med en hovedmodel på 125 milliarder parametre, suppleret af yderligere 51 milliarder parametre fordelt på N-gram-embeddings. Under inferens aktiveres 6 milliarder parametre per token, så kun en brøkdel af de samlede parametre bruges ved hver forespørgsel. Modellen har et nativt kontekstvindue på 262.144 tokens, som kan udvides til op mod 1 million tokens. NVIDIA Developer beskriver modellen som klar til afprøvning på selskabets GB300 NVL72-platform, med fokus på agentisk kodning.
Alibaba udgiver vægte til Qwen3.8-Flash-Next som forsmag på Qwen4-arkitektur
Artikel29. august 2026 kl. 00.22 Martin S. Nielsen
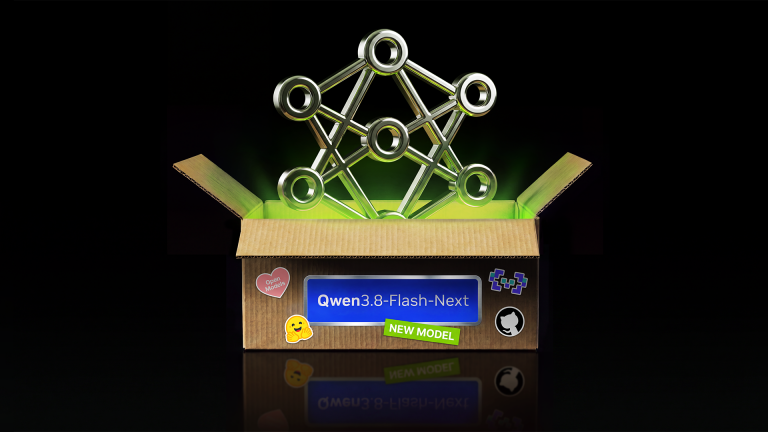
Foto: NVIDIA Developer
Alibaba har frigivet modelvægtene til Qwen3.8-Flash-Next, så udviklere kan afprøve og evaluere modellen.
AI-genereret indhold
Annonce
Prisen er faldet
Faldet er målt af os på varens laveste pris inkl. fragt, ikke på butikkens egen førpris. Vi kan tjene provision, hvis du køber via et link.
Relaterede artikler
- Alibaba frigiver åbne vægte til 2,4 billioner-parameter-model Qwen3.8-MaxAlibaba har frigivet de åbne vægte til Qwen3.8-2.4T-A95B, der også går under navnet Qwen3.8-Max.
- Ollama kan nu omsætte tekst til tale med PhononOllama understøtter nu tekst til tale. Den første talemodel er Phonon, en familie af små modeller fra Gradium,...
- DGX Spark 64GB ruller ud fredag, kan samles i klynger på otte enhederNVIDIA DGX Spark 64GB ruller ud via partnere fra fredag den 23.
- Nvidia udgiver nye åbne Nemotron 3.5-modeller på Hugging FaceNVIDIA har udvidet sin portefølje af åbne modeller med nye familier til sprog, billeder og søgning.